分类目录归档:不是技术

再造轮子

在VPS上的服务被封了,是整个IP都被墙了。

问了一下前同事,如果自己写协议有多难?他建议基于PCI的标准来写(彻底防中间人攻击)

就是用TLS1.3了。

于是让AI给建议,AI说,你就别折腾框架的事情了,Client直接用现成的,把基于TLS1.3的私有协议封装在sing_box中。

于是让AI开工,另外通知VPS厂商帮我换IP

可能是轻车熟路,AI很快就弄好了,加上大量的压力测试。

然后我一键部署……

跑起来比商用的效果还差不了多少。

看看PCI标准是不是真的可以对抗哈。


上面的工作用了kimi Moderato 1/3的月额度,大概就是30块钱左右。今天(周二)想起要在Android上也跑个客户端。

还是让Kimi继续吧,但挺不顺利,毕竟是跨设备调试。途中出去了一趟,用UU远程指挥kimi修改,然后远程下配置到本地(我没让他再改二进制,因为用的是sing box+私有协议,不存在特别的bug),再验证,如是过了几个红绿灯都还没好。

算了,还是等回家好好给它看log吧。

于是kimi终于找到了问题:

这次是源码级的实锤根因,完整证据链如下:

根因:我们的配置没开 route.auto_detect_interface。sing-box 的拨号器只有在这个开关为 true 时才会给每个出站连接挂上 VPNService.protect()(回环保护)。没挂保护 → 核心自己发往服务器的连接被路由进自己的 tun → 死循环。日志里的铁证:拨号失败的源地址是 172.18.0.1(tun 自己的地址)、所有连接 15 秒后报 mux: tunnel not connected。Wi-Fi 和蜂窝症状一样,因为都卡在这一步——之前看到的”运营商 RST”只是隧道还没建好时的次要现象。

为什么官方 SFA 没这问题:订阅/图形界面生成的配置会带上这个开关,而我们是手写 JSON,漏了。源码里 Android 被算作 Linux(constant/os.go:23),所以这个”仅桌面”的选项在 Android 上合法且必需。

于是改配置项就好了。

又用了大概1/3月额度。


个人感觉,近三十年的技术经验,不过就是清晰地表达问题,收集log,以及恰当提出一些建议——不让它质疑一个开源已久的项目。

Kimi moderato 月费99,1/3就是一杯咖啡的价格,相当的划算了。我是相信Kimi蒸馏A\很到位,所以它技术能力挺强的。
一个把prompt engineering软件化的思路

大多数的垂直设计软件对于一个复杂的产品来说,都做得非常的臃肿。AI的使用改变了这一点,也打死了这些垂直设计软件。

但可以生存下来的是那些并不依赖于垂直行业的通用设计软件,比如Blender。

这也是为什么Blender MCP + Codex做得越来越好的原因。

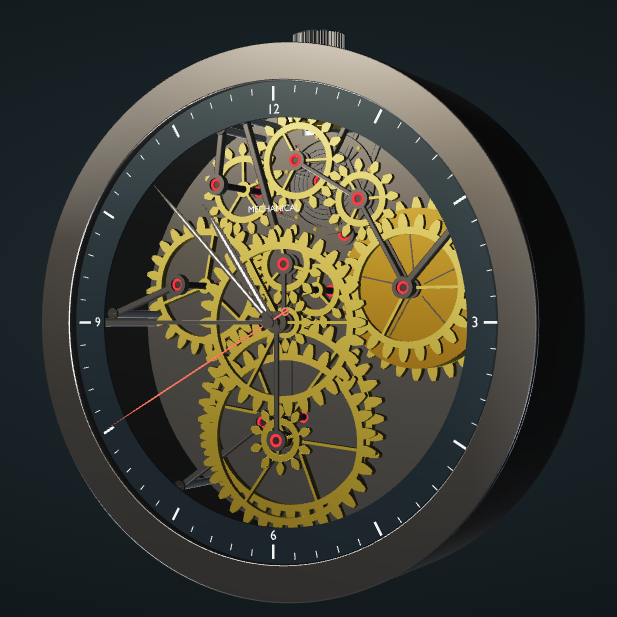
这是我完成MOCworld(一个(目标)专业的Lego方案设计软件) 和 钟表设计demo后的经验。


如果你为了一个垂直行业,不断用AI去重写这个CAD,结果就是再次累积了大量的CAD软件的代码,质量先不说,但结果还是重建一个屎山——即使洁癖如我,也只是让它控制规模,尽量不耦合的方式去外挂一些别的功能。

我知道很多人已经在这么做。

但最终用户/付费方要的是什么?是一个设计好的方案,并不是有一个可以做这个方案的传统软件。


在钟表设计(是钟表设计的demo展示,不是软件的demo展示),我才用了一个新的思路,其实也是旧的思路——回到prompt engineering。

  1. 让deepseek根据要做的事情,给出一个step by step的prompts流
  2. 让codex逐步去实现
  3. 每一步完成后需求方(需要有经验和想法,类似于产品经理)介入,给出反馈,deepseek修正prompt 或者给出prompt patch,重复该步;确认没问题就继续下一步。
  4. 完整实现后,deepseek给出全局的prompt
  5. codex也总结出全局过程以及prompt
  6. 参考codex的结果,deepseek修正自己的prompt
  7. codex用新的全局prompt一次性完整实现
  8. 检查最终结果,继续修正全局prompt
  9. 根据系统/平台需要,提取prompt中可参数化、定制化的部分
  10. 软件化这些可参数化和定制化的内容
  11. 构造该定制系统

最终会得到一个根据定制需求生产可重复实施的prompts,该prompts将提交给codex进行最终的结果生成/合成。

如何保障结果的一致?就是这个prompt所要求的细节有多么精确了。

(上述codex、deepseek可以更换为两种不同的前沿LLM)

顺便展示一下,这次多轮迭代出来的prompt,一次性让codex做好的钟表模型。

codex开发鸿蒙应用

codex自身还是有点过度自信,今天让它在仿真器上实现一个接rtsp摄像头 截屏和录制的功能的demo,它似乎没有太关心鸿蒙原生SDK是否支持rtsp的问题 吭哧吭哧搞了半天 这不行那不行的。

于是我看了一眼Google 然后告诉它 鸿蒙原生SDK可能不大支持rtsp 你应该用某个开源库的native c++来处理。

然后codex就听进去了。于是才改好了。

如果你说人类现在比AI还强在什么地方,可能就是context还算多,切换效率也算高,切换过程中,保留的cache context?效率更高更好吧。

另外 视频处理经历了二三十年 真的是相当成熟了 为什么那么好 监控的需求其实是不足以推动这些技术有如此完美的 还是娱乐业影视业这些吧 宣扬文化和意识形态,再就是消费主义要洗脑 都需要音视频的传播 AI的视频生成 这几年也一直是大头 也是这两年才比coding 大模型略弱……

重部署了一下网站

不知不觉,hostinger已经用了一年,感觉还可以,但是续费不便宜,研究了一下,最经济的方法是重新注册一个账号,然后把内容转移过去。

于是就搞了一把。

这次买了两年,现在对花在IT上的开销略略有点敏感,因为AI的开销已经陆续上来了,互联网1.0 2.0 3.0的重要性没那么大,于是考虑除了让自己在世界上继续留有痕迹之外,多余的就不要搞那么多。

如果域名/网站本身就在hostinger上,迁移还是略麻烦,要先把上面的域名绑定解除,然后在新的hostinger账户内才能选中。

网站内容备份和数据库备份都比较简单,ftp上传网站内容,phpmyadmin导入sql,然后恢复反而不需要用官方的工具了。

另外,看到网上又说官方也提供网站clone的工具,不过是2x USD,我找了找没有相关链接,自己细心一点,慢慢做,2个小时也处理完了。

如果去年bluehost不是停止服务,我不会换hostinger,web hosting的生意估计也做到我们这一代人为止了。我看小孩们并不会关心自己是否需要一个网站的可能。如果真有项目,估计会用ai直接构建一个流行的表达方式,比如github?

IP从美东换成印尼了,果然快了很多,跟去年选择不一样,现在美国对接的可能性变小了。

openspec-apply-change

最近项目越做越复杂,于是上下文不大够用了。

apply change的时候,它虽然有一个tasks.md作工作规划,但codex屡屡把项目方方面面读进context,没有什么产出,就又compact了。

这样效果很低。

于是打断它,要求小步快跑,盯着tasks.md逐个完成,一聚焦,事情就流畅了。

突破微信贴图号“添加位置”限制

用EXIF修改让旧照片重新拥有精准地理标记

一份关于如何让世界各地拍摄的旧照片,在微信贴图号中获得准确位置推荐的技术笔记。

功能与痛点:为什么你的老照片加不了位置?

微信的贴图号(部分用户称为图片动态/状态,一种可发布图片、文字并附带位置的轻内容功能)有一个非常实用的机制:

  • 发布贴图时,你可以选择 “添加位置”。
  • 一旦位置添加得当,该条贴图就有机会被推荐给该地点附近的人,带来大量自然曝光。

然而,这个“位置”并非随便就能加上。微信允许添加的位置来源只有两个:

  1. 手机当前地理位置
    发图时,手机会定位你所在的位置,并允许你在方圆2公里内的具体地点中选择一个。
  2. 图片内嵌的EXIF信息
    微信会读取图片文件中的 EXIF GPS坐标,若图片是在“近期”拍摄的,就能直接识别出对应的地点,让你添加。

这里便出现了困扰许多用户的限制:

  • 老照片失效:我在几年前周游世界时拍的照片,因为不是“近期拍摄”,EXIF时间戳过旧,微信完全不予识别。
  • 无法回到现场:我不可能再飞回那些国家,仅为了站在当地发一条贴图。而通过模拟定位工具伪造手机GPS,又很容易被微信安全策略识别,存在风险。

结论就是:历史照片的全球足迹,几乎不可能再被激活。

解决思路:给EXIF做一次“时间平移与GPS移植”

既然微信只信任“近期拍摄且携带GPS”的图片,那么关键突破口就在 EXIF元数据。

我需要的操作本质非常简单:

  • 将一张带有正确GPS坐标的照片,其 拍摄时间 修改为最近(例如昨天或今天)。
  • 如果原图GPS信息已丢失,就重新写入正确的经纬度。

这样处理后,微信就会认为这是一张刚刚在当地拍摄的照片,从而允许我添加该地点。

但是,手动修改成千上万张旧照片并不现实。于是我让AI写了一个轻量小工具,专门批量/定向完成EXIF更新。

实践步骤:只需修改一张图,轻松激活所有图

整个工作流经过测试,确实生效,而且极其省力:

  1. 准备一张锚点图
    选出一张需要添加位置的地点的照片,或者任意一张图。用工具将其EXIF中的 DateTimeOriginal 改为近一两天,并确保 GPSLatitude、GPSLongitude 等字段正确填入该地点的坐标。
  2. 发布贴图,获取位置
    打开微信贴图号,选择这张刚修改过的图片。微信识别到EXIF中的近期时间和GPS后,“添加位置”列表中会出现对应的地点。选中并发布。
  3. 补充上传其他图片
    这条贴图一旦带着正确位置发布成功后,你可以立即编辑或补充上传其他旧照片(那些未修改EXIF的图片)。此时位置已固定,不再需要每张图都通过EXIF校验。

一次修改,激活全部。 优雅地绕过了时间与距离的双重限制。

工具要点与注意事项

  • 修改EXIF的工具:使用Python (piexif, Pillow) 或现成的命令行工具(exiftool)均可,AI辅助可快速生成脚本。
  • 时间窗口:观察发现,“近期”大致在一个月内,为保险起见建议把拍摄时间改为 最近24小时。
  • 避免滥用模拟定位:修改图片EXIF属于本地文件处理,不会触发微信的模拟定位检测,相比直接伪造手机GPS要安全得多。
  • 合规使用:本方法仅用于将个人历史旅行照片还原真实拍摄地点,以实现内容展示与记录,请勿用于虚假打卡、位置欺骗等违规行为。

结语

微信贴图号的地理围栏机制,曾经让无数精彩的“老照片足迹”被封存。借助EXIF元数据的灵活修改,我们重新获得了定义位置的能力。这不仅是对旅行记忆的一次数字复原,也为内容创作者解锁了更灵活的地点表达方式。

你过去在冰岛、在撒哈拉、在某个无名小镇按下的快门,现在终于能够带着它们原本的坐标,出现在它应该出现的人群视野里。


codex的能力

有个持续了2个月的任务:做一个零件之间的冲突的检测算法,然后从1000+个样本里面,看看有多少被检测成伪冲突。这些样本都是成熟的方案,本身并不存在伪冲突。

用codex 5.4的时候,一开始还好,但一段时间之后,它发现我事实上是希望这些样本里面检测的伪冲突清零,于是就用坐标值堆数组的方式,给我一个假象,带来的问题就是这些分支越来越多,数组也越来越多。

我也发现了这个问题,于是让它处理维度提升,但一直到我该用5.5,这种情况终于有了数量级的提升。真的按照零件的逻辑而非数值来帮我处理。

不过也不能完全归咎于5.5和5.4的差异。毕竟在这过程中,我对这个问题的认识也深入了很多:

要检测到连接、冲突,又不能把正常连接/靠近处理成伪冲突,还要考虑检测性能的问题。

海贼王 追平 进度

看了一年多,终于把海贼王追到最新的进度了。然后就可以先忘掉,毕竟尾田效率也就那样。

连载最大的问题就是,前后呼应不上,有作者心境的变化,也有读者/观众的影响,所以要连载成就一个完美的作品,基本上是不可能的。

另外就是环境也在变化,即使作者没忘掉初心,资本和市场的要求,也会让他与时俱进(中性)。

回过头来看vibe coding / AI agent,也是亦步亦趋,多轮之后,还能想起最初的目的吗?或者最初的目的的模糊性,在边做边清晰的前提下,发现原来是自相矛盾,或者俗不可耐?

anthropic的小心机

早上发现Deepseek + Claude Code用不了了:API Error: 400 Failed to deserialize the JSON body into the target type: messages[1].role: unknown variant `system`, expected `user` or `assistant` at line 1 column 29561

问了一下google,是CC升级了,在里面加入了‘system’的role,而一般的第三方模型不会/来不及就它的毛病,就不支持这个role,于是报错。

没有非常好的办法。最后我选择了回退Claude Code:npm install -g @anthropic-ai/claude-code@2.1.148

但是也就是打开那一下是可以了 /exit 出来,重新进,就又变成 2.1.154了。

那每次使用都install 2.1.148再用?或者跳离它这条船。

codex的陷阱

这两天终于碰到一个。

我持续用codex为场景识别并收敛伪冲突。这几天碰到有若干个场景,伪冲突被codex收敛得很快,基本上3分钟内就告诉我,这场景的伪冲突已经清零了。

然后我每天都会让Deepseek + Claude Code帮我检查总冲突数的收敛情况。然后根据剩余的大头再委托codex去处理。

早上DS返回的结果跟昨天返回的结果类似,有些大头完全没有清理。我一开始以为DS搞错了,然后把结果给codex double check,codex一开始还是说它确实清干净了。

随着对质的深入,codex终于发现它的问题,它选了两个错误的数据域作为判断的标准,结果导致这两天的伪清零……

至于它为什么这么选,之前是没有这样做的。大模型毕竟是一种推理机制,如果KPI需要它清零,它会选择一个看上去能达到结果的判断方式,而并非费力地推导出各种机制和规则。简单来说,改测试代码,直接通过。

多模型联合工作,审核,避免偷懒,看来是必须的。